

Metrics 采集方式
AutoMQ 通过以下两种方式提供 Prometheus 兼容的监控能力:- Remote Write: AutoMQ 将 Metrics 直接推送到用户提供的 Prometheus Remote Write Endpoint。创建或更新实例时配置 Endpoint 和身份验证信息。
- Exporter: AutoMQ 提供 Prometheus 兼容的拉取 Endpoint,由用户的监控系统定期采集。
- Kubernetes 部署: 使用 Kubernetes 资源上的标准 Prometheus Annotation 发现采集 Endpoint。
- 虚拟机部署: 使用云厂商提供的主机 Tag 发现目标主机。
Prometheus Metrics 定义
指标名称、Label 和详细定义请参见开源版文档中的 Prometheus Metrics。Grafana 仪表盘示例
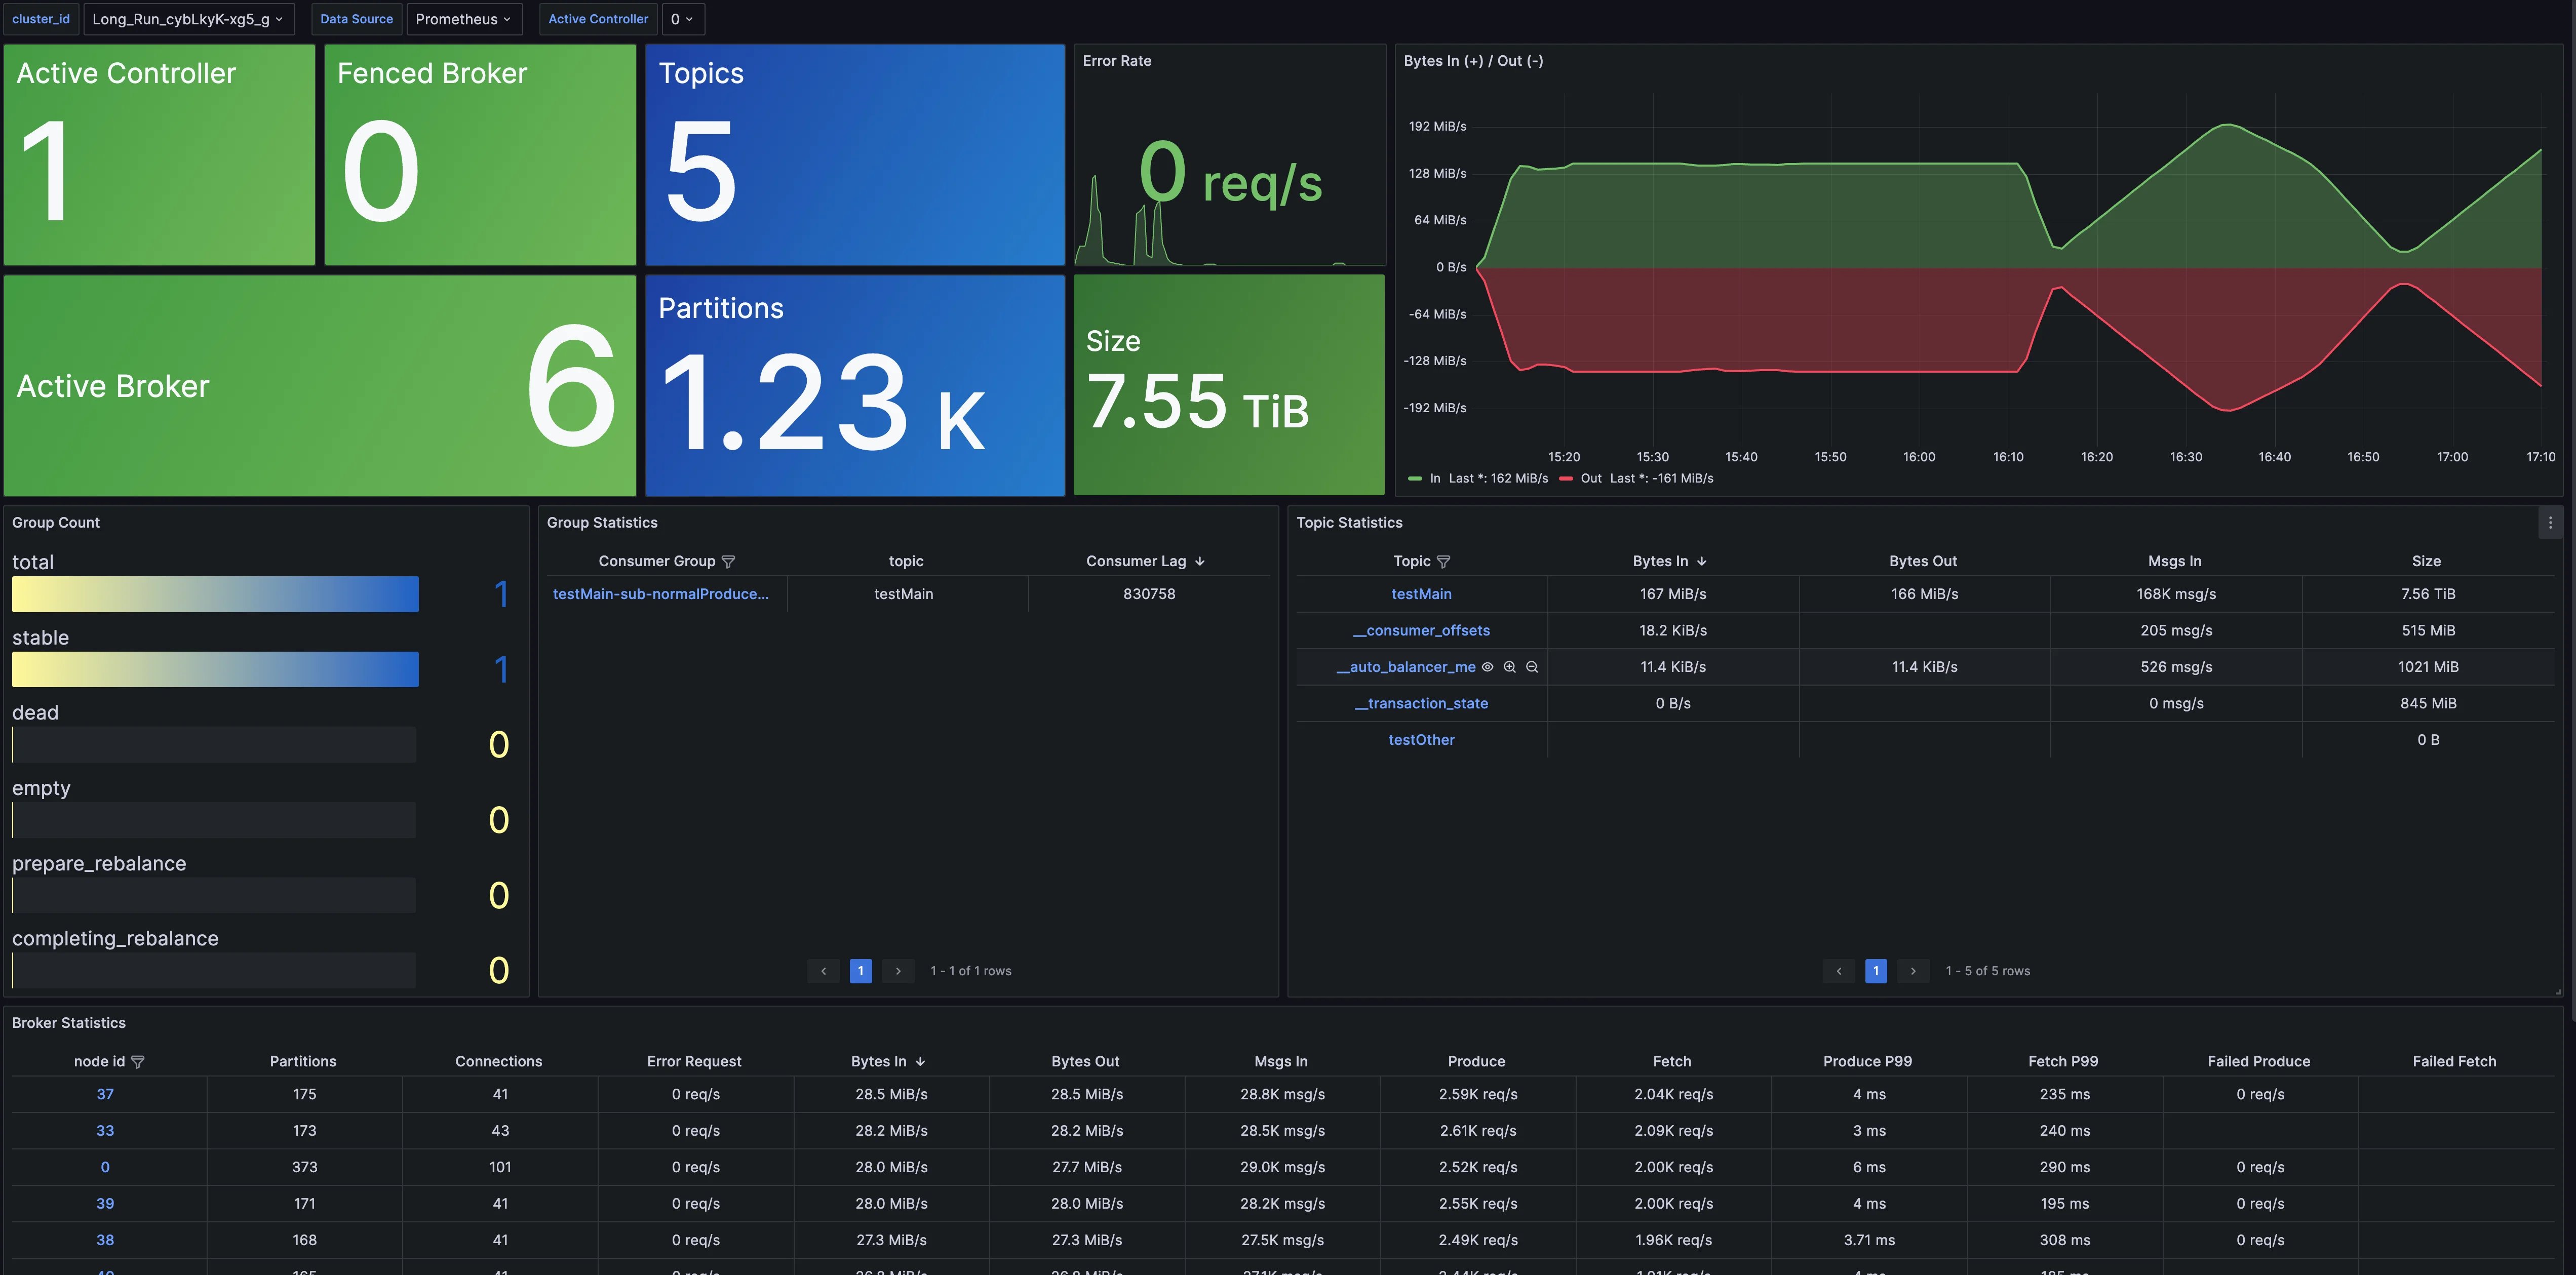
如上文所述, AutoMQ Cloud 暂不提供托管的 Grafana 仪表盘服务,用户参考AutoMQ 提供的 Grafana 模板快速配置仪表盘,相关仪表盘模板请前往此处链接下载。 预置的 Grafana 大盘模板提供了不同维度的指标监控:- Cluster Overview: 提供了集群维度的监控,包括节点数量、数据大小、集群流量等,以及Topic、Group、Broker 维度的指标概览,并提供了下钻功能,可跳转至对应的详情监控
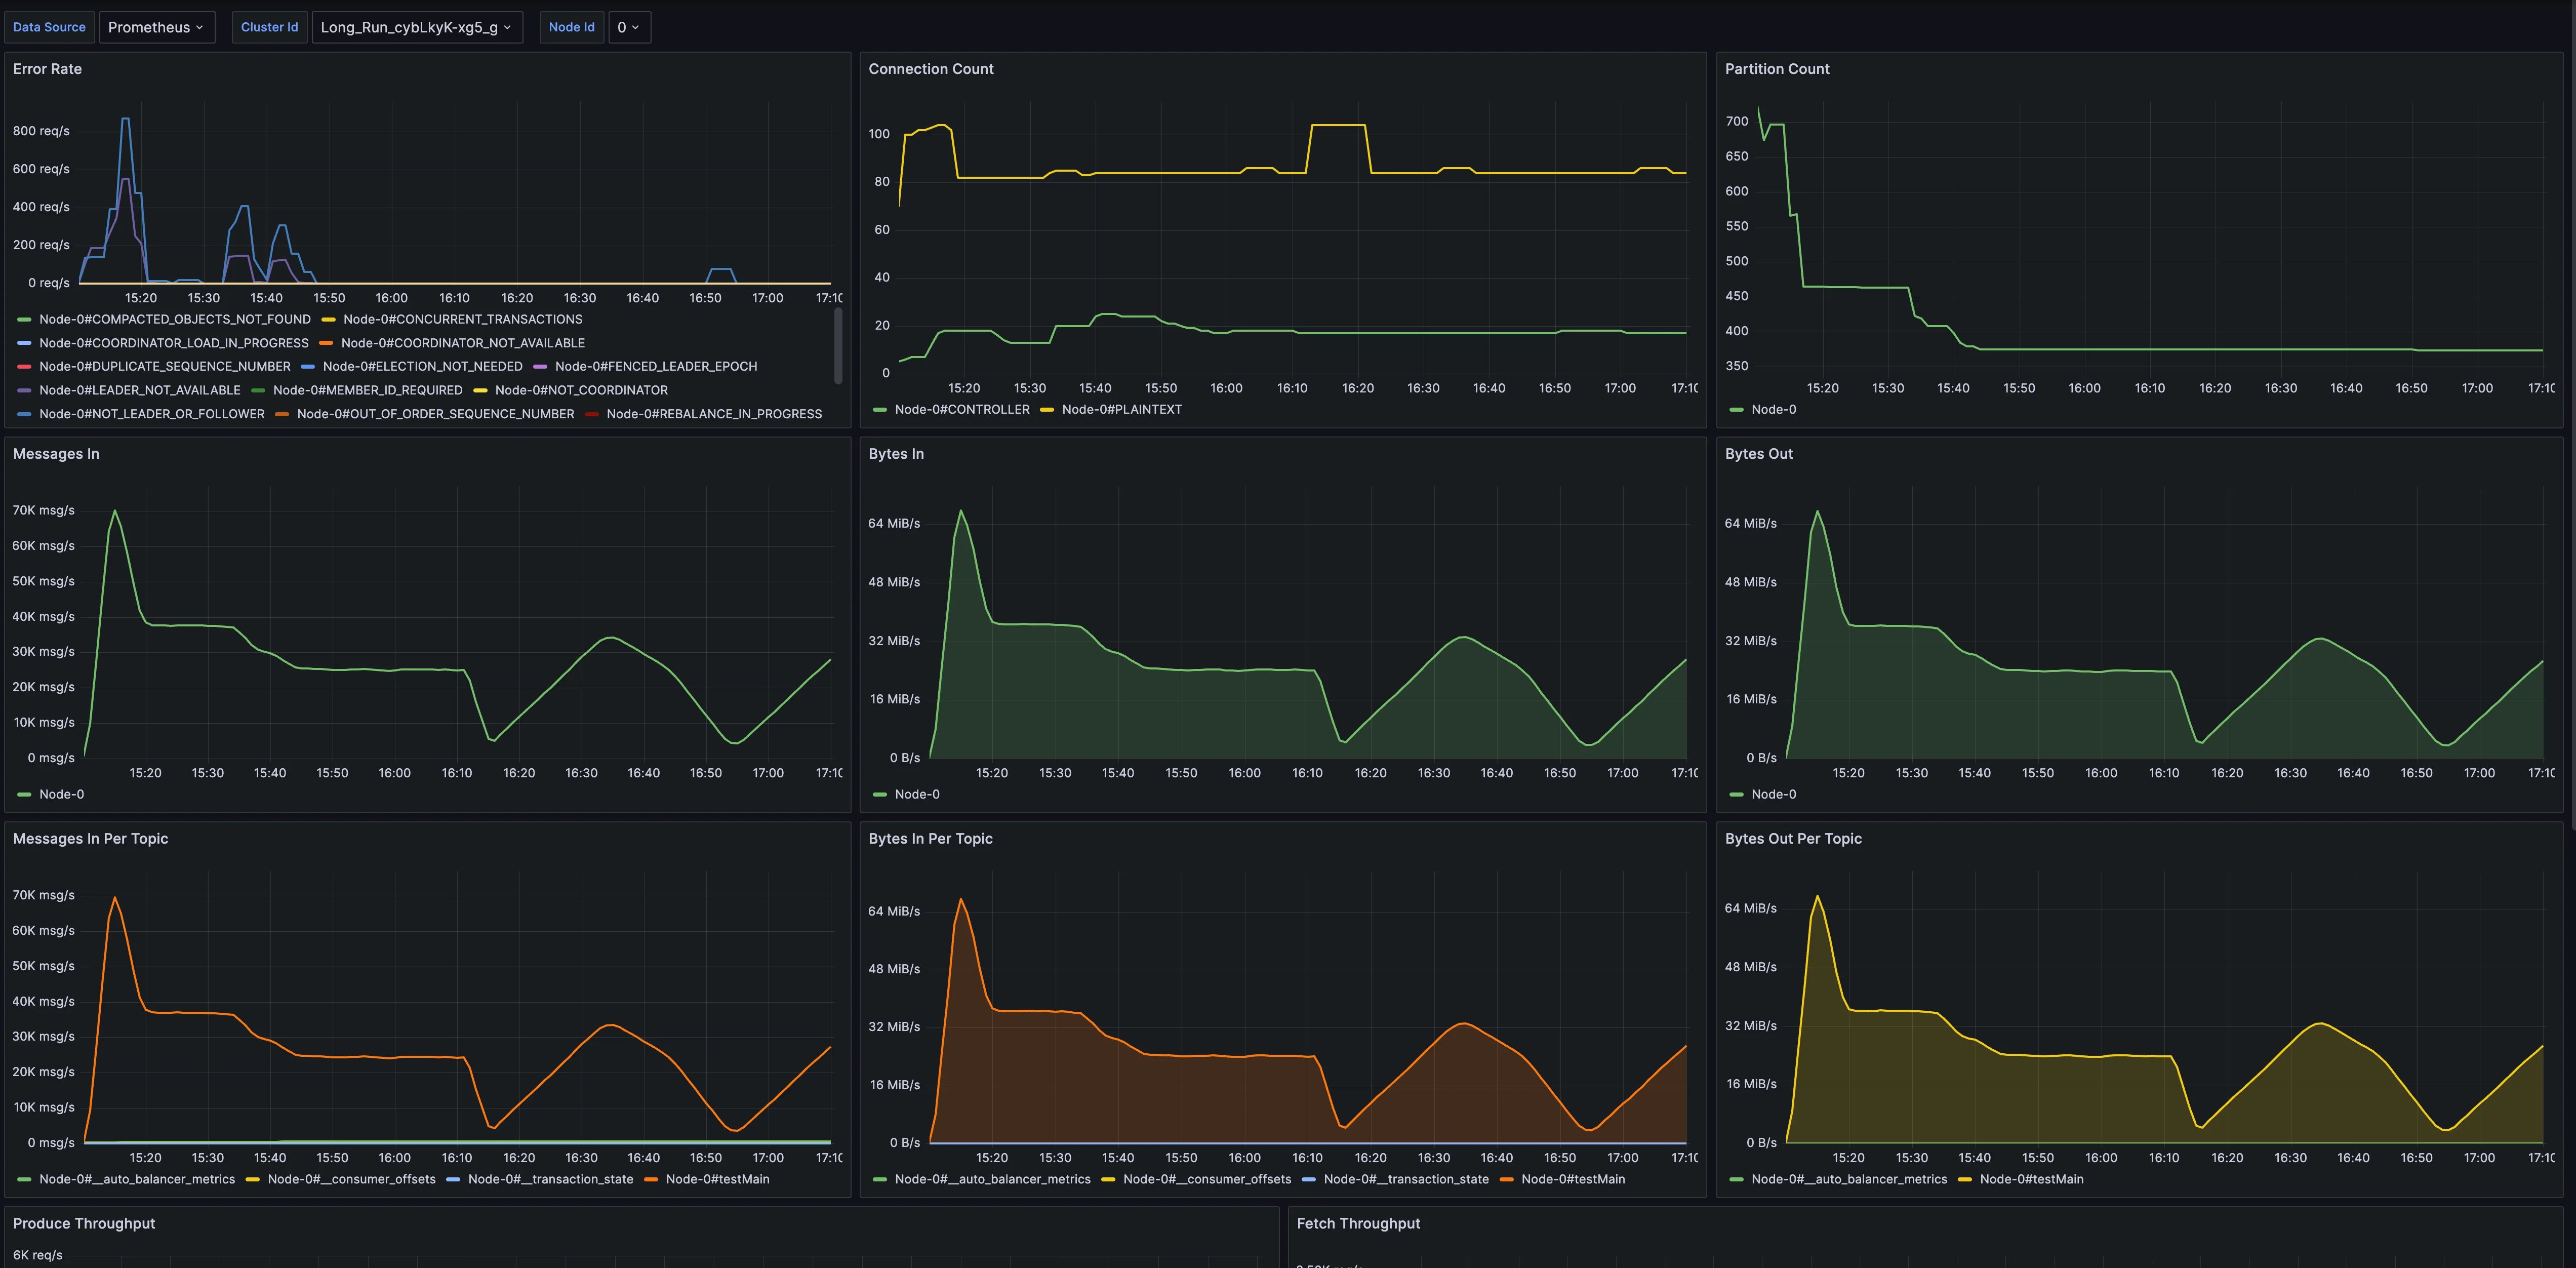
- Broker Metrics: 提供了 Broker 维度的监控,包括连接数量、分区数量、节点流量、节点请求等
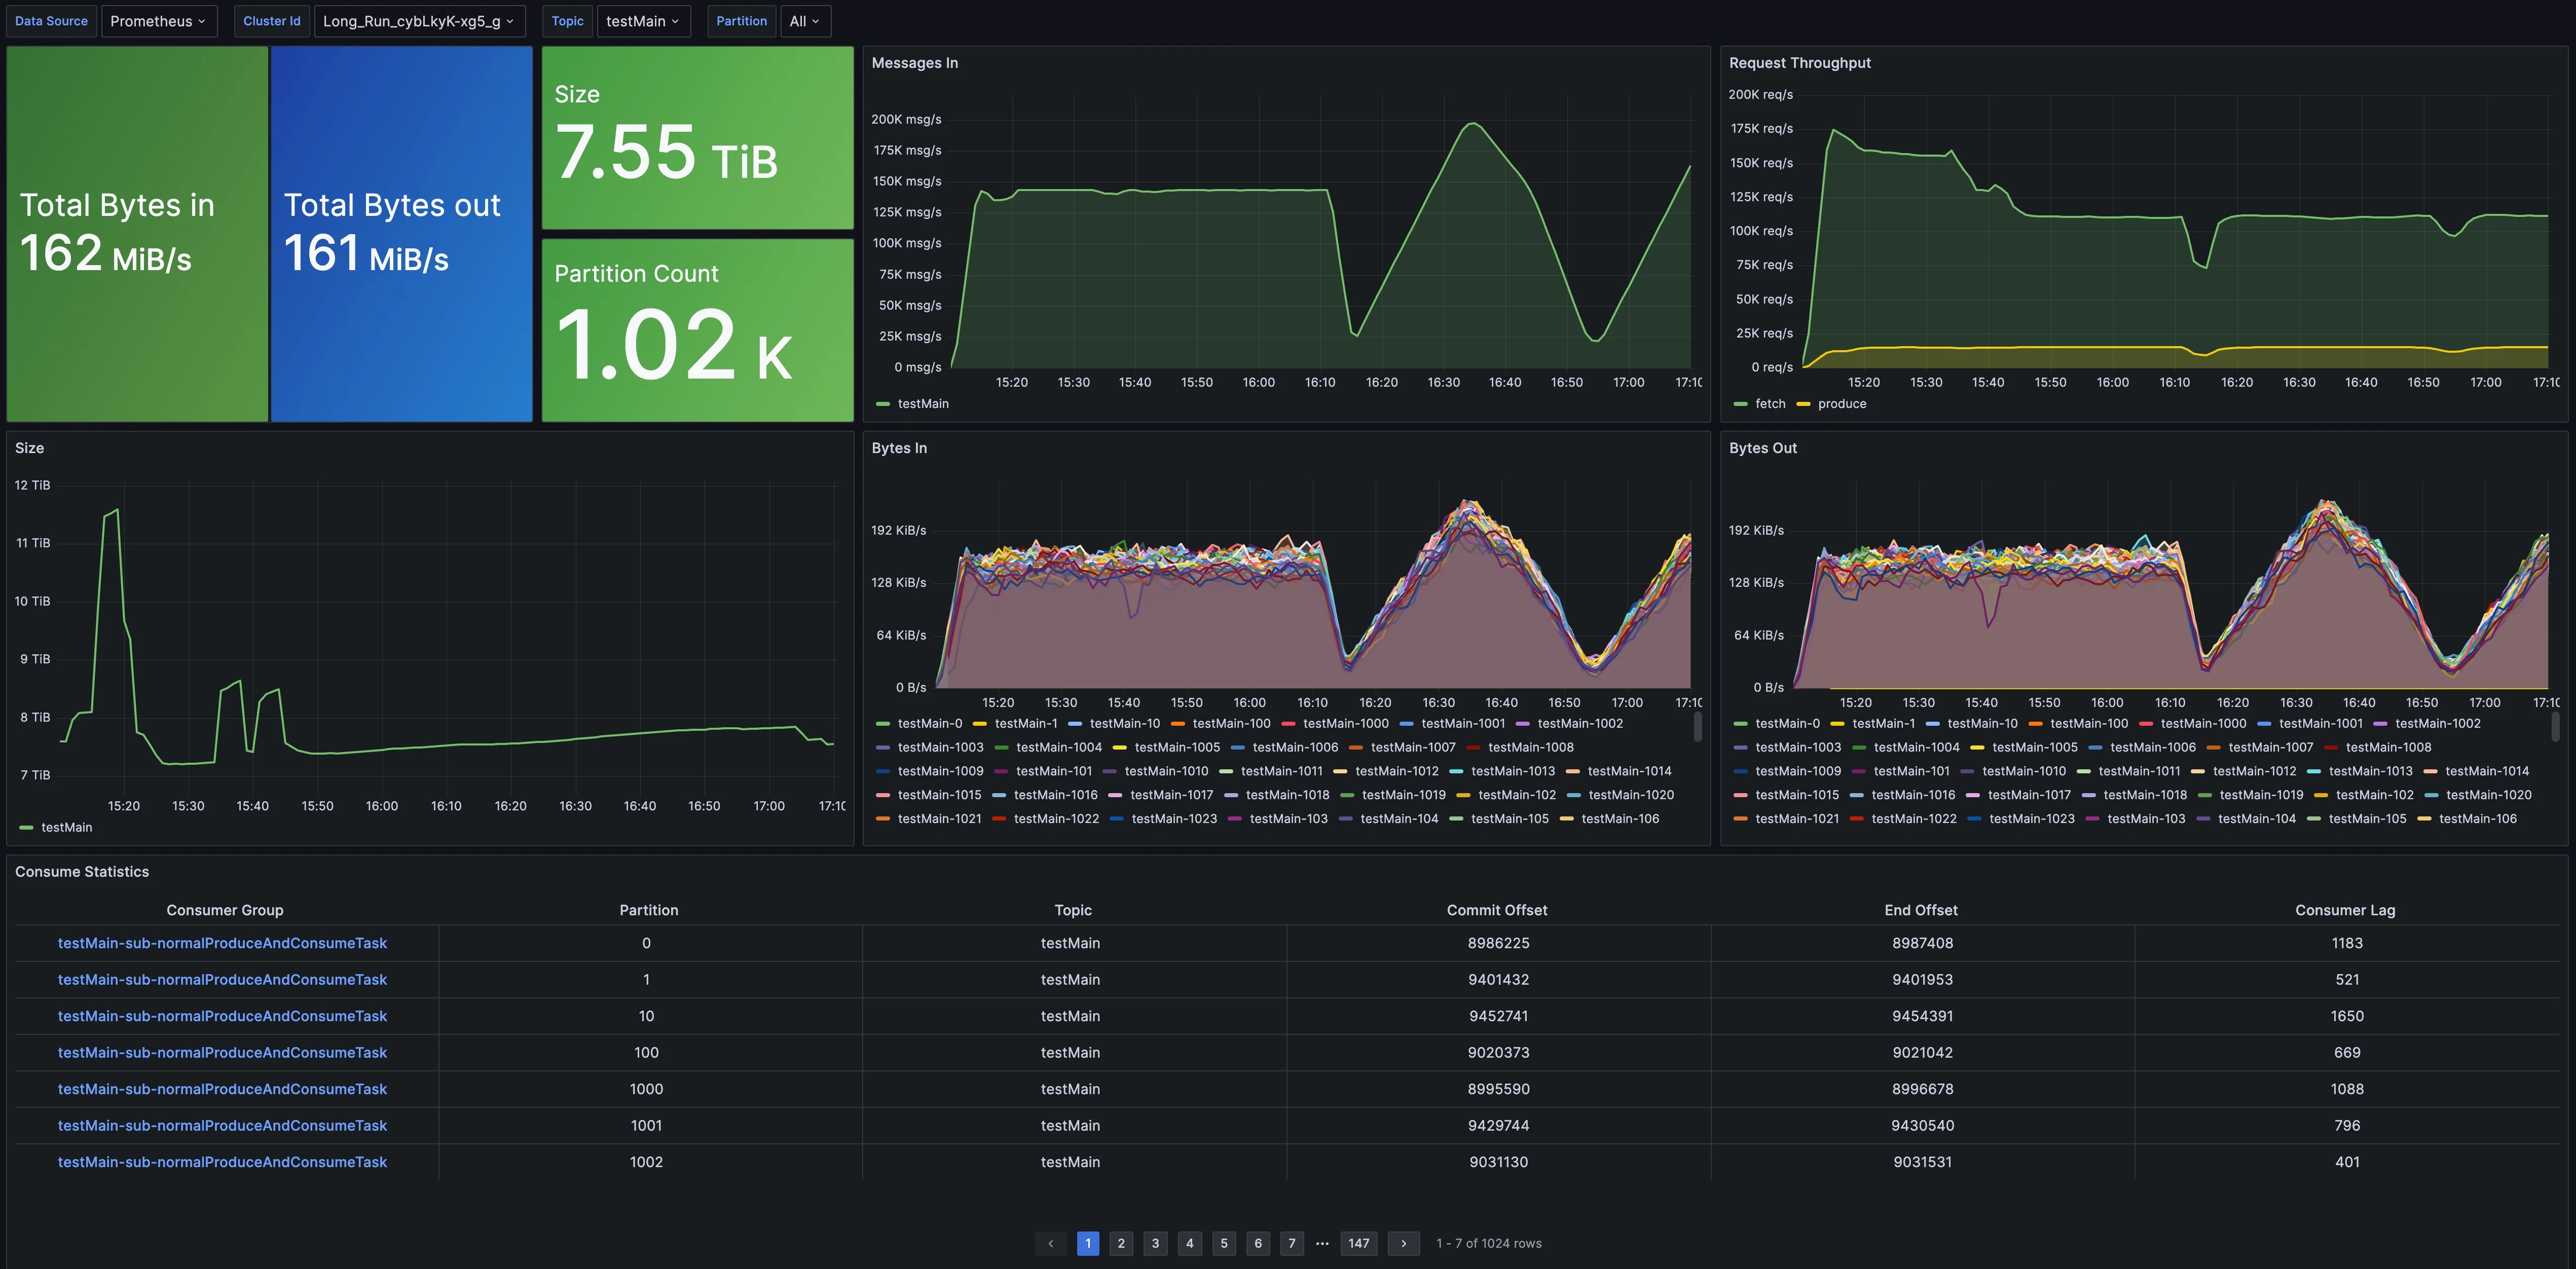
- Topic Metrics: 提供了 Topic 维度的指标监控,包括消息吞吐、数据总量、分区数量、消费延迟等
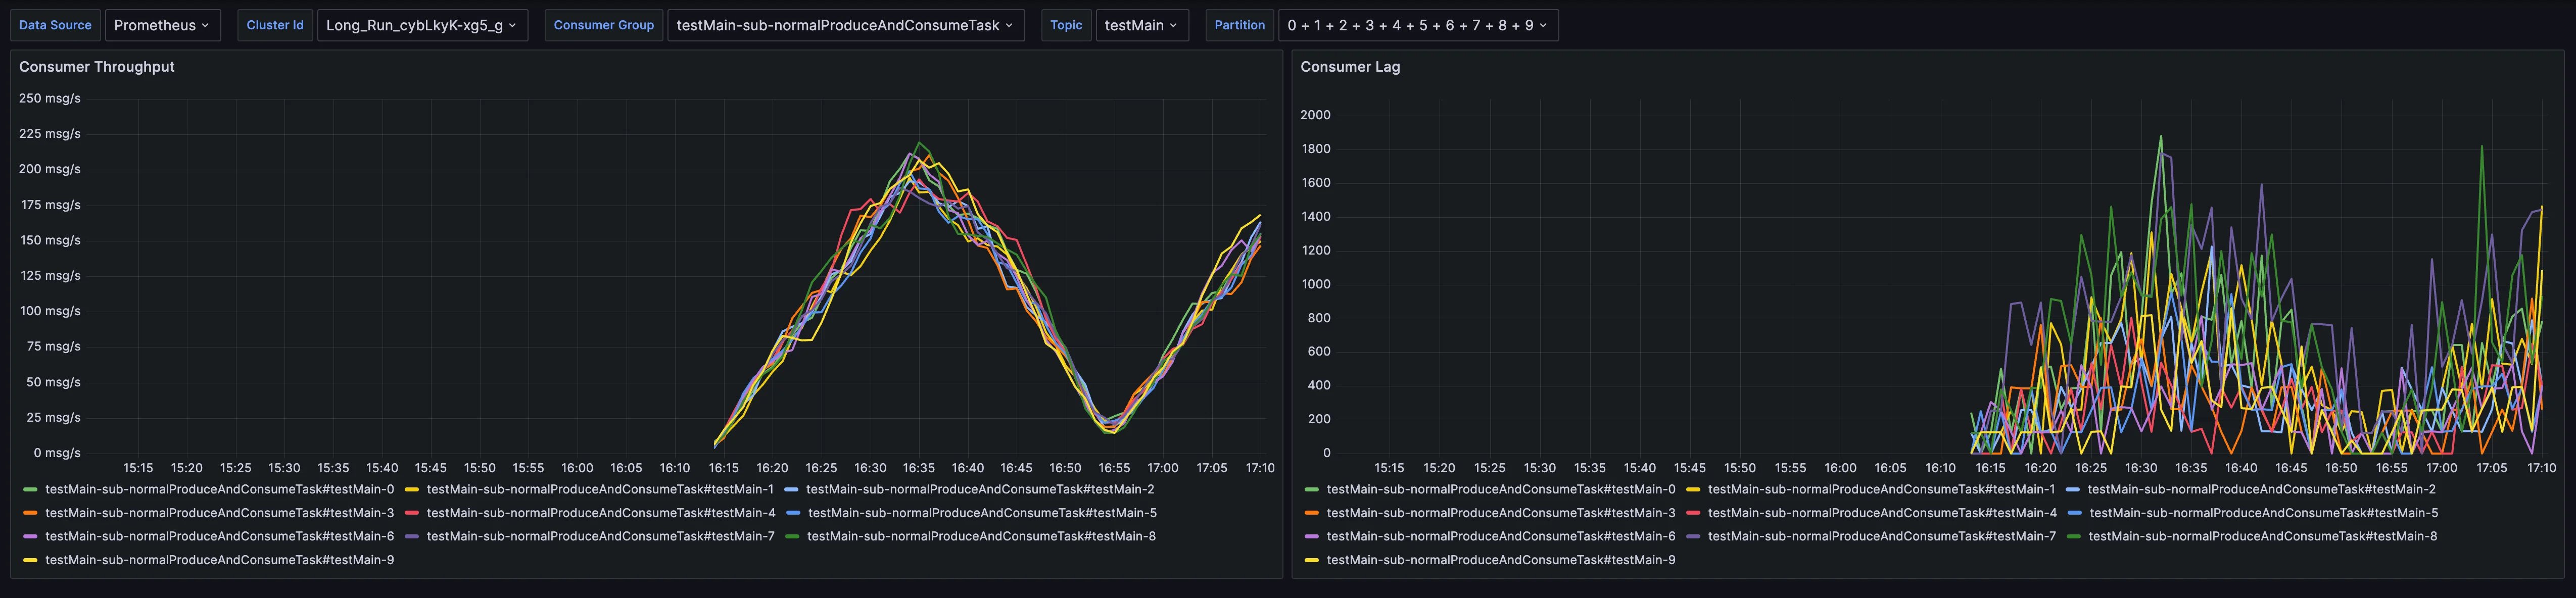
- Group Metrics: 提供了 Group 维度的指标监控,包括消费速率和消费延迟
业务监控报警
将 AutoMQ Metrics 接入 Prometheus 后,可按业务需要配置集群容量、Topic 写入和 Consumer time lag 告警。Kafka 集群报警模板
这些规则是面向业务的 Prometheus 告警模板。选择需要关注的规则,并按业务流量和时效要求调整筛选条件、阈值及持续时间。 Prometheus 负责评估规则,Alertmanager 负责通知路由。使用前请确认当前部署会输出规则使用的指标。不同部署和版本的指标与标签可能不同。下例假设job 表示集群;如果 job 表示采集任务,请改用实际的集群标识标签。
Prometheus 规则示例
模板默认匹配所有非空 Topic 和 Consumer group。请按需调整topic、group 筛选条件和比较阈值,以匹配需要监控的资源和业务。
Managed Connector 报警模板
AutoMQ 针对 Managed Connector 场景同样提供了一系列报警模板,用于监控 Connector 任务状态、资源使用和数据处理异常等情况。 报警规则模板列表如下:
完整的报警模板 yaml 文件参考下方,可以用于复制导入。